180 minut | poziom podstawowy | Python/Jupyter | praca w parach
Tym razem jesteśmy analitykami opinii publicznej! Wykorzystamy autentyczną ankietę CBOS z grudnia 2017 roku (Aktualne problemy i wydarzenia, nr 331; 925 respondentów), ankietę StudentSurvey (do testów średnich i rang) oraz historyczne dane Student’s Sleep (próby sparowane).
A pisze kod, B pilnuje hipotez, założeń i interpretacji. Po każdym zadaniu zamieniacie się rolami. Pola None to miejsca do samodzielnego uzupełnienia; wskazówki otwierają się po kliknięciu.
Źródła danych: student
Pakiety: numpy, pandas, matplotlib, scipy, statsmodels, pyreadstat, ipywidgets. Jeśli czegoś brakuje, uruchom w oddzielnej komórce Jupyter: %pip install pyreadstat statsmodels ipywidgets.
Rozkład czasu: 0–45 jedna średnia i testy kierunkowe; 45–60 CBOS: jedna proporcja; 60–70 przerwa; 70–105 niezależne średnie / rangi; 105–135 próby sparowane; 135–155 CBOS: zależności; 155–170 KDE; 170–180 podsumowanie.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats
from statsmodels.stats.proportion import proportions_ztest
from pathlib import Path

plt.style.use('seaborn-v0_8-whitegrid')
DATA_URL='https://raw.githubusercontent.com/kflisikowsky/sad/main/data'
DATA_DIRS=(
    Path('dane'),
    Path('data'),
    Path('Wnioskowanie_statystyczne_blok_2/dane'),
    Path('Wnioskowanie_statystyczne_blok_2/data'),
)

def find_local_dataset(filename):
    for directory in DATA_DIRS:
        candidate=directory/filename
        if candidate.is_file():
            return candidate
    return None

def read_dataset(filename):
    local_path=find_local_dataset(filename)
    if local_path is not None:
        return pd.read_csv(local_path)
    return pd.read_csv(f'{DATA_URL}/{filename}')

survey=read_dataset('student_survey_lock5.csv')
sleep=read_dataset('sleep_paired.csv')

exercise=survey.Exercise.dropna().to_numpy()
tv_f=survey.loc[survey.Sex=='F','TV'].dropna().to_numpy()
tv_m=survey.loc[survey.Sex=='M','TV'].dropna().to_numpy()
drug1=sleep.drug1.to_numpy()
drug2=sleep.drug2.to_numpy()
diff=drug2-drug1
print('Ankieta:',len(survey),'odpowiedzi; sleep:',len(sleep),'par')
Ankieta: 362 odpowiedzi; sleep: 10 par
%pip install pyreadstatCollecting pyreadstat
Downloading pyreadstat-1.3.7-cp313-cp313-macosx_11_0_arm64.whl.metadata (1.2 kB)
Requirement already satisfied: narwhals>=2.10.1 in /opt/miniconda3/lib/python3.13/site-packages (from pyreadstat) (2.27.1)
Requirement already satisfied: numpy in /opt/miniconda3/lib/python3.13/site-packages (from pyreadstat) (2.5.2)
Downloading pyreadstat-1.3.7-cp313-cp313-macosx_11_0_arm64.whl (804 kB)
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 804.8/804.8 kB 16.1 MB/s eta 0:00:00
Installing collected packages: pyreadstat
Successfully installed pyreadstat-1.3.7
Note: you may need to restart the kernel to use updated packages.
Nowy zbiór: CBOS bez ręcznego pobierania
Wczytamy plik .sav z GitHuba oraz etykiety pytań z SPSS. W razie kłopotów z modułem odczytu, zainstaluj go komendą %pip install pyreadstat w osobnej komórce i ponownie uruchom poniższą.
import pyreadstat
from urllib.request import urlretrieve

url_cbos = 'https://raw.githubusercontent.com/kflisikowsky/sad/main/data/CBOS_201733_331_SPSS.sav'
plik_cbos = find_local_dataset('CBOS_201733_331_SPSS.sav')
if plik_cbos is None:
    data_dir = next((directory for directory in DATA_DIRS if directory.exists()), Path('dane'))
    data_dir.mkdir(parents=True, exist_ok=True)
    plik_cbos = data_dir / 'CBOS_201733_331_SPSS.sav'
    print('Pobieram ankietę CBOS (ok. 1,2 MB)...')
    urlretrieve(url_cbos, plik_cbos)
cbos, meta_cbos = pyreadstat.read_sav(str(plik_cbos))
print('CBOS:', cbos.shape[0], 'respondentów,', cbos.shape[1], 'zmiennych')
for zmienna in ['q24', 'q25', 'plec']:
    i = meta_cbos.column_names.index(zmienna)
    print('—', zmienna, '—', meta_cbos.column_labels[i])
    print(meta_cbos.variable_value_labels.get(zmienna, {}))
CBOS: 925 respondentów, 189 zmiennych
— q24 — 1. Czy, ogólnie rzecz biorąc, sytuacja w naszym kraju zmierza w dobrym czy też w złym kierunku?
{1.0: 'W dobrym', 2.0: 'W złym', 7.0: 'Trudno powiedzieć', 8.0: 'Odmowa odpowiedzi'}
— q25 — 2. A jak Pan(i) sądzi, czy w ciągu najbliższego roku sytuacja w Polsce poprawi się, pogorszy czy też się nie zmieni?
{1.0: 'Zdecydowanie poprawi się', 2.0: 'Raczej poprawi się', 3.0: 'Nie zmieni się', 4.0: 'Raczej pogorszy się', 5.0: 'Zdecydowanie pogorszy się', 7.0: 'Trudno powiedzieć', 8.0: 'Odmowa odpowiedzi'}
— plec — Płeć respondenta
{1.0: 'Mężczyzna', 2.0: 'Kobieta'}
0–45 min. Case study A: jedna średnia
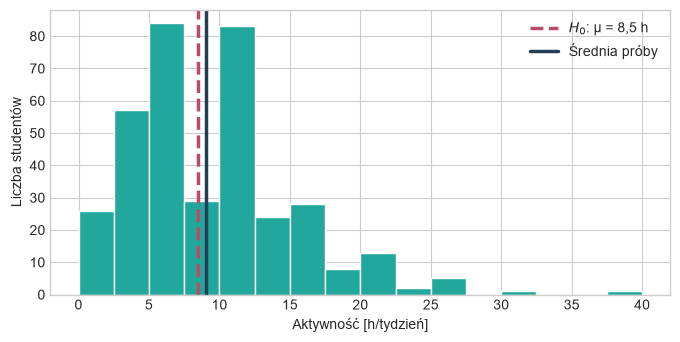
W ankiecie Exercise oznacza deklarowaną liczbę godzin aktywności fizycznej na tydzień.
Pytanie: czy przeciętnie jest to 8,5 godziny tygodniowo? Próg 8,5 godziny to wartość dydaktyczna, nie oficjalna rekomendacja.
H₀: μ = 8,5. Najpierw zapisz H₁, dopiero potem patrz na wyniki.
print('n =',len(exercise),'średnia =',exercise.mean().round(2),'odchylenie =',exercise.std(ddof=1).round(2))
fig,ax=plt.subplots(figsize=(8,3.7))
ax.hist(exercise,bins=16,color='#21a79c',edgecolor='white')
ax.axvline(8.5,color='#bd4a68',lw=2.5,ls='--',label=r'$H_0$: μ = 8,5 h')
ax.axvline(exercise.mean(),color='#213e55',lw=2.5,label='Średnia próby')
ax.set(xlabel='Aktywność [h/tydzień]',ylabel='Liczba studentów')
ax.legend();plt.show()
n = 361 średnia = 9.05 odchylenie = 5.74
Zadanie 1. Test t dla jednej średniej — DWUSTRONNY
H₁: μ ≠ 8,5. Zastosuj funkcję dla jednej próby.
Założenia: niezależni respondenci; pomiar ilościowy; przy mniejszej próbie w przybliżeniu normalny rozkład i brak bardzo silnych odstających. Przy n≈361 test t bywa odporny na umiarkowaną nienormalność, ale warto ocenić obserwacje odstające.
wyniki=test_two=stats.ttest_1samp(exercise, popmean=8.5, alternative='greater')  # TODO: wywołanie SciPy
if test_two is None: print('Uzupełnij test_two')
else: print('t =',round(test_two.statistic,3),'p dwustronne =',round(test_two.pvalue,5))
TtestResult(statistic=np.float64(1.8336163648790507), pvalue=np.float64(0.03376819130590094), df=np.int64(360))blad = exercise.std(ddof=1)/np.sqrt(len(exercise))
print('Błąd standardowy średniej =',round(blad,3))Błąd standardowy średniej = 0.302
💡 Podpowiedź 1: funkcja
stats.ttest_1samp()
🔎 Podpowiedź 2: argumenty
stats.ttest_1samp(exercise, popmean=8.5, alternative=“two-sided”)
Zadanie 2. Test JEDNOSTRONNY — prawostronny
Gdy przed obejrzeniem danych zakładamy kierunek dodatni, H₁: μ > 8,5. Przy H₁: μ < 8,5 otrzymalibyśmy test lewostronny.
W testach jednostronnych nie dzielimy mechanicznie każdego p przez dwa. Kierunek statystyki musi być zgodny z H₁.
test_right=None  # TODO: ta sama funkcja, inny parametr
if test_right is None: print('Uzupełnij test_right')
else: print('t =',round(test_right.statistic,3),'p prawostronne =',round(test_right.pvalue,5))
Uzupełnij test_right
💡 Podpowiedź 1: funkcja
stats.ttest_1samp()
🔎 Podpowiedź 2: argumenty
Podaj alternative=“greater”. Dla H₁: μ < 8,5 użyłbyś alternative=“less”.
proportions_ztest(43,362, 0.2,alternative='smaller')(np.float64(-4.776084989332397), np.float64(8.937043693949779e-07))Interaktywny eksperyment: jeden ogon czy dwa?
Poniższy kod rysuje dokładnie te same dane i tę samą statystykę t, ale inaczej definiuje obszar p-value. Przed uruchomieniem przewidź, czy wnioski przy α = 0,05 będą identyczne.
from ipywidgets import interact, Dropdown
def draw_tails(direction='two-sided'):
    t_obs=(exercise.mean()-8.5)/(exercise.std(ddof=1)/np.sqrt(len(exercise)))
    x=np.linspace(-4,4,800); y=stats.t.pdf(x,df=len(exercise)-1)
    fig,ax=plt.subplots(figsize=(8,3.7))
    ax.plot(x,y,color='#215d66',lw=2.7)
    if direction=='two-sided':
        ax.fill_between(x,0,y,where=(np.abs(x)>=abs(t_obs)),color='#ce506e',alpha=.9)
    elif direction=='greater':
        ax.fill_between(x,0,y,where=(x>=t_obs),color='#ce506e',alpha=.9)
    else:
        ax.fill_between(x,0,y,where=(x<=t_obs),color='#ce506e',alpha=.9)
    res=stats.ttest_1samp(exercise,8.5,alternative=direction)
    ax.axvline(t_obs,color='#ce506e',ls='--')
    ax.set(yticks=[],xlabel='Statystyka t przy $H_0$',
           title=f'$H_1$: {direction};  t={res.statistic:.3f},  p={res.pvalue:.4f}')
    plt.show()
interact(draw_tails,direction=Dropdown(options=[('dwie strony','two-sided'),('prawa','greater'),('lewa','less')],description='H₁:'));
W parach: zapisz obie hipotezy H₁ i obydwa p-value. Czy wolno wybrać test prawostronny dopiero po tym, jak test dwustronny okazał się nieistotny? Dlaczego nie?
45–60 min. Case study B — CBOS: czy Polacy byli optymistami?
W grudniu 2017 r. CBOS zapytał: „Czy, ogólnie rzecz biorąc, sytuacja w naszym kraju zmierza w dobrym czy też w złym kierunku?” (q24).
Najpierw obejrzyj odpowiedzi. Nie licz „trudno powiedzieć” jako „nie” — to osobna kategoria! W ćwiczeniu rozważamy wyłącznie osoby, które wskazały jednoznacznie „dobry” lub „zły” kierunek.
Zadanie 3 (para): sprawdź, czy udział opinii „w dobrym kierunku” różnił się od 50% (wartość odniesienia jest dydaktyczna, nie historyczna). Sformułuj H₀ i H₁. Dlaczego test powinien być dwustronny, jeśli wcześniej nie określiliśmy kierunku?
# Autentyczne odpowiedzi CBOS (kodowane 1: dobry, 2: zły, 7: trudno powiedzieć, 8: odmowa)
print('Liczebności surowych odpowiedzi:')
print(cbos['q24'].value_counts(dropna=False).sort_index())
opinie = cbos.loc[cbos['q24'].isin([1, 2]), 'q24']
k_dobry = int(opinie.eq(1).sum())
n_opinie = len(opinie)
print('Ważne odpowiedzi:', n_opinie, '| „dobry”:', k_dobry, '| udział:', round(k_dobry / n_opinie, 3))

wynik_cbos = None  # TODO: wpisz proporcje z testu Z; usuń spację nietypową w nazwie jeśli przepisujesz
if wynik_cbos is None:
    print('Uzupełnij wywołanie testu.')
else:
    print('z =', round(wynik_cbos[0], 3), 'p =', round(wynik_cbos[1], 5))
Liczebności surowych odpowiedzi:
q24
1.0    432
2.0    345
7.0    145
8.0      3
Name: count, dtype: int64
Ważne odpowiedzi: 777 | „dobry”: 432 | udział: 0.556
Uzupełnij wywołanie testu.
💡 Podpowiedź 1: gotowa funkcja
Użyj proportions_ztest() z statsmodels.stats.proportion.
🔎 Podpowiedź 2: argumenty
Potrzebujesz: count=k_dobry, nobs=n_opinie, value=0.5, alternative='two-sided'. Aby użyć wariancji z hipotezy zerowej, dodaj prop_var=0.5.
Pytanie do dyskusji: co stałoby się z oszacowaniem odsetka, gdyby odpowiedzi „trudno powiedzieć” omyłkowo włączyć do mianownika?
Interpretacja i ograniczenia: wynik opisuje grudzień 2017 r., nie dzisiejsze nastroje. Przybliżenie normalne w prostym teście Z wymaga dostatecznych liczności i niezależnych obserwacji; CBOS ma również wagi ankietowe (WAGA, wagaDUZA) i własny schemat doboru. Nasz nieważony test jest ćwiczeniem metody, nie odtworzeniem oficjalnego wnioskowania CBOS.
W parach: zapisz jednym zdaniem, czym jest p-value i czego na pewno nie oznacza. Czy z istotności statystycznej wynika automatycznie duże znaczenie społeczne?
60–70 min. Przerwa
70–105 min. Case study C: dwie niezależne średnie
Porównamy tygodniowy czas oglądania TV przez kobiety (F) i mężczyzn (M). Są to dwa rozłączne zbiory respondentów.
fig,ax=plt.subplots(figsize=(8,3.7))
ax.boxplot([tv_f,tv_m],tick_labels=['kobiety','mężczyźni'])
ax.set(ylabel='TV [h/tydzień]',title='Zróżnicowanie TV — StudentSurvey')
plt.show()
print('n:',len(tv_f),len(tv_m),'średnie:',tv_f.mean(),tv_m.mean())
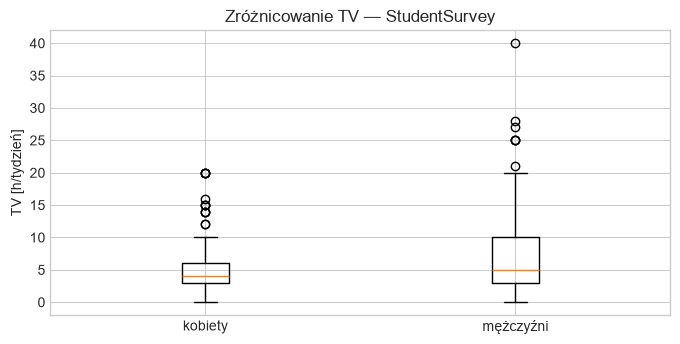
n: 169 192 średnie: 5.236686390532545 7.619791666666667
Zadanie 3. Welch
H₀: μF = μM; H₁: μF ≠ μM. Test Welcha nie wymaga równości wariancji.
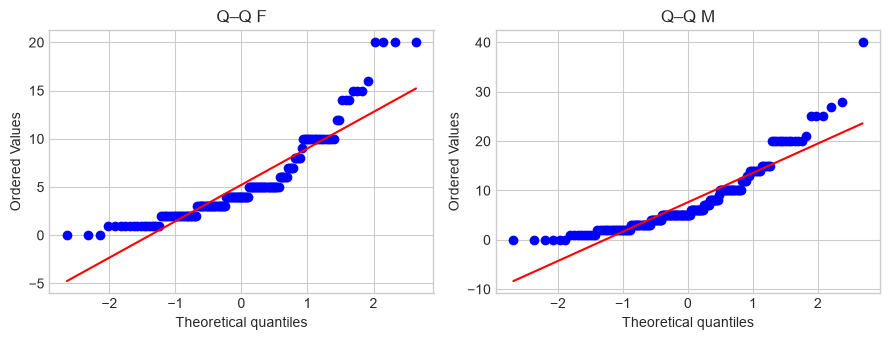
Założenia: niezależność osób, dane ilościowe, brak silnych obserwacji wpływowych; w małych próbach także przybliżona normalność. Czy dane TV są prawoskośne?
result_welch=None  # TODO: użyj gotowej funkcji
if result_welch is None: print('Uzupełnij result_welch')
else:
    print('t =',result_welch.statistic,'p =',result_welch.pvalue)
    print('95% CI różnicy F-M:',result_welch.confidence_interval())
Uzupełnij result_welch
💡 Podpowiedź 1: funkcja
stats.ttest_ind()
🔎 Podpowiedź 2: argumenty
stats.ttest_ind(tv_f, tv_m, equal_var=False) — Welch.
Diagnostyka i alternatywa
Nie traktuj Shapiro jako automatycznej bramki. Niezależność pochodzi z projektu badania. Mann–Whitney jest zamiennikiem badającym inne aspekty rozkładów, nie zawsze same mediany.
print('Shapiro F:',stats.shapiro(tv_f))
print('Shapiro M:',stats.shapiro(tv_m))
print('Levene:',stats.levene(tv_f,tv_m))
fig,axs=plt.subplots(1,2,figsize=(9,3.5))
stats.probplot(tv_f,dist='norm',plot=axs[0]);axs[0].set_title('Q–Q F')
stats.probplot(tv_m,dist='norm',plot=axs[1]);axs[1].set_title('Q–Q M')
plt.tight_layout();plt.show()
Shapiro F: ShapiroResult(statistic=np.float64(0.8316548109545009), pvalue=np.float64(1.1080814246073763e-12))
Shapiro M: ShapiroResult(statistic=np.float64(0.8427904665842125), pvalue=np.float64(3.95506403534183e-13))
Levene: LeveneResult(statistic=np.float64(12.681801445178488), pvalue=np.float64(0.000418966330848194))
Zadanie 4. Mann–Whitney: porównanie rozkładów
result_mw=None  # TODO
if result_mw is None: print('Uzupełnij result_mw')
else: print('U =',result_mw.statistic,'p =',result_mw.pvalue)
Uzupełnij result_mw
💡 Podpowiedź 1: funkcja
stats.mannwhitneyu()
🔎 Podpowiedź 2: argumenty
stats.mannwhitneyu(tv_f, tv_m, alternative=“two-sided”)
105–135 min. Case study D: dwie obserwacje tej samej osoby
Historyczny Student’s Sleep: dodatkowe godziny snu pod wpływem leku 1 i leku 2. Jedna linia na wykresie to ta sama osoba — dane sparowane.
fig,ax=plt.subplots(figsize=(8,3.7))
for a,b in zip(drug1,drug2):ax.plot([1,2],[a,b],'-o',alpha=.65,color='#159d95')
ax.set(xticks=[1,2],xticklabels=['lek 1','lek 2'],ylabel='Dodatkowy sen [h]')
plt.show()
print('Średnia różnica lek 2 - lek 1:',diff.mean())
print('Shapiro różnic:',stats.shapiro(diff))
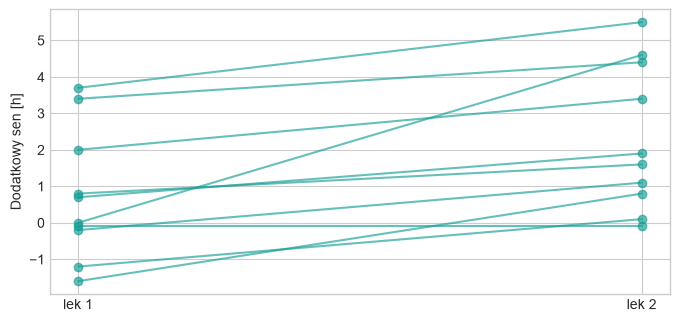
Średnia różnica lek 2 - lek 1: 1.58
Shapiro różnic: ShapiroResult(statistic=np.float64(0.8298713319287947), pvalue=np.float64(0.0333416086303077))
Zadanie 5. Test t dla par
H₀: średnia różnica D=drug2−drug1 wynosi 0.
Założenia: poprawne parowanie, niezależność par, przy małym n w przybliżeniu normalny rozkład RÓŻNIC. Nie wymagamy normalności obu kolumn osobno.
result_paired=None  # TODO
if result_paired is None: print('Uzupełnij result_paired')
else: print(result_paired,'CI:',result_paired.confidence_interval())
Uzupełnij result_paired
💡 Podpowiedź 1: funkcja
stats.ttest_rel()
🔎 Podpowiedź 2: argumenty
stats.ttest_rel(drug2, drug1)
Zadanie 6. Wilcoxon
Alternatywa oparta na rangach |D| i ich znakach. Typowa interpretacja centrum różnic wymaga ich symetrii; uwaga na zera i remisy.
result_wilcoxon=None  # TODO
if result_wilcoxon is None: print('Uzupełnij result_wilcoxon')
else: print(result_wilcoxon)
Uzupełnij result_wilcoxon
💡 Podpowiedź 1: funkcja
stats.wilcoxon()
🔎 Podpowiedź 2: argumenty
stats.wilcoxon(diff)
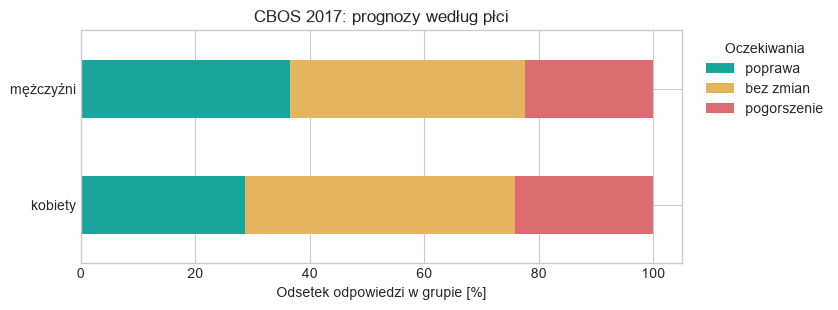
135–155 min. Case study E — CBOS: czy kobiety i mężczyźni oceniali przyszłość inaczej?
Pytanie q25: „Czy w ciągu najbliższego roku sytuacja w Polsce poprawi się, pogorszy czy też się nie zmieni?” (zadane w grudniu 2017 r.).
Kodujemy trzy rozłączne kategorie: poprawa (1/2), bez zmian (3), pogorszenie (4/5). Odpowiedzi 7/8 (nie wiem/odmowa) usuwamy. Następnie porównujemy odpowiedzi według płci (plec: 1 – mężczyzna, 2 – kobieta).
Wasze wyzwanie: najpierw obejrzyjcie wykres procentowy. Czy wizualna różnica jest wystarczającą podstawą do stwierdzenia zależności?
mapa = {1: 'poprawa', 2: 'poprawa', 3: 'bez zmian', 4: 'pogorszenie', 5: 'pogorszenie'}
cbos_analiza = cbos.loc[cbos['plec'].isin([1, 2]) & cbos['q25'].isin(mapa)].copy()
cbos_analiza['prognoza'] = cbos_analiza['q25'].map(mapa)
cbos_analiza['grupa'] = cbos_analiza['plec'].map({1: 'mężczyźni', 2: 'kobiety'})
tab_cbos = pd.crosstab(cbos_analiza['grupa'], cbos_analiza['prognoza'])
print('Liczności:')
display(tab_cbos)
procenty = tab_cbos.div(tab_cbos.sum(axis=1), axis=0) * 100
ax = procenty[['poprawa', 'bez zmian', 'pogorszenie']].plot(
    kind='barh', stacked=True, figsize=(8.5, 3.2), color=['#18a59b', '#e5b45f', '#dd6c72'])
ax.set(xlabel='Odsetek odpowiedzi w grupie [%]', ylabel='', title='CBOS 2017: prognozy według płci')
ax.legend(title='Oczekiwania', bbox_to_anchor=(1.02, 1), loc='upper left')
plt.tight_layout(); plt.show()
Liczności:
Zadanie 7. Test niezależności χ²
H₀: płeć i kategoria prognozy są niezależne. H₁: występuje zależność.
Użyj jednej gotowej funkcji
scipy.statsdo przetestowania niezależności.Sprawdź najmniejszą liczność oczekiwaną.
Oceń wielkość efektu — V Craméra (wzór i podpowiedź poniżej).
Napisz, dlaczego istotna zależność nie oznacza, że płeć powoduje określoną odpowiedź.
from scipy.stats import PermutationMethod
wynik_chi = stats.chi2_contingency(tab_cbos,correction=False,method=PermutationMethod(n_resamples=9999,batch=None, random_state=None,rng=None))

wynik_chi
Chi2ContingencyResult(statistic=np.float64(6.214420257543603), pvalue=np.float64(0.0441), dof=nan, expected_freq=array([[204.81955763, 108.33876601, 149.84167637],
       [175.18044237,  92.66123399, 128.15832363]]))
💡 Podpowiedź 1: gotowy test
stats.chi2_contingency() z argumentem tab_cbos.
🔎 Podpowiedź 2: co oznacza V Craméra?
(V=\sqrt{\chi^2/(N\min(r-1,c-1))}). W przedziale 0–1: 0 oznacza brak związku; duże wartości oznaczają silniejszy związek. Porównuj wartość także z kontekstem badania.
🧭 A co z testem dwóch proporcji?
Gdy uprościsz zmienną q25 do dwóch kategorii (poprawa versus pozostałe ważne odpowiedzi), porównaj odsetki kobiet i mężczyzn za pomocą proportions_ztest(count=[...,...], nobs=[...,...]). Nie używaj tej samej funkcji do pełnej tabeli 2×3!
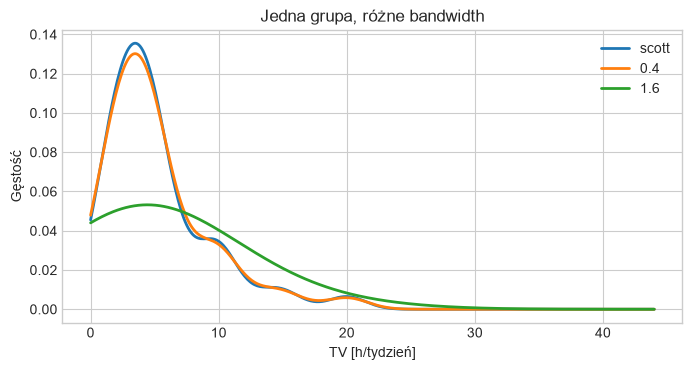
155–170 min. Case study F: KDE
Jądrowa estymacja gęstości opisuje kształt rozkładu godzin TV. Nie jest testem hipotez. Bandwidth decyduje o poziomie wygładzania.
grid=np.linspace(0,max(tv_f.max(),tv_m.max())+4,400)
fig,ax=plt.subplots(figsize=(8,3.8))
for bw in ['scott',.4,1.6]:
    kde=stats.gaussian_kde(tv_f,bw_method=bw)
    ax.plot(grid,kde(grid),label=str(bw),lw=2)
ax.set(xlabel='TV [h/tydzień]',ylabel='Gęstość',title='Jedna grupa, różne bandwidth')
ax.legend();plt.show()
Zadanie 8. Narysuj na jednej osi dwa KDE dla F i M. Zastosuj identyczną regułę wyboru pasma.
kde_f=None  # TODO
kde_m=None  # TODO
if kde_f is None or kde_m is None: print('Uzupełnij obie funkcje')
else:
    fig,ax=plt.subplots(figsize=(8,3.8))
    ax.plot(grid,kde_f(grid),label='F')
    ax.plot(grid,kde_m(grid),label='M')
    ax.legend();ax.set(xlabel='TV [h/tydzień]',ylabel='Gęstość');plt.show()
Uzupełnij obie funkcje
💡 Podpowiedź 1: funkcja
stats.gaussian_kde()
🔎 Podpowiedź 2: argumenty
stats.gaussian_kde(tv_f, bw_method=“scott”) i osobno dla tv_m.
170–180 min. Zakończenie
W parach uzupełnijcie krótką tabelę: pytanie, hipotezy H₀/H₁, test, założenie, zamiennik, wynik i ograniczenie.
Najważniejsze pytanie: kiedy i dlaczego wolno użyć testu jednostronnego?
ANOVA zostaje na kolejny blok.